
Web scraping - kiedy jest legalny? Przykłady
W artykule znajdziesz omówienie konkretnych sytuacji - kiedy możesz zastosować web scraping, a kiedy może to być ryzykowne. Decyduje o tym sposób, zakres i cel planowanego działania. Świadome planowanie procesu, znajomość przepisów i analiza technicznych aspektów to najlepsze zabezpieczenie.

Czas na omówienie konkretnych sytuacji - kiedy możesz zastosować web scraping, a kiedy może to być ryzykowne.
Jeżeli nie zapoznałeś/zapoznałaś się jeszcze z pierwszym artykułem o web scrapingu, to zachęcam Cię do przeczytania. Ułatwi Ci to zrozumienie prawnych aspektów omawianych w tym artykule przykładów.
Z tego artykułu dowiesz się:
- o technicznym procesie scrapowania danych. To, co kryje się za poszczególnymi krokami w tym procesie, ma znaczenie w prawnej ocenie projektu,
- czy korzystanie z ogólnodostępnych narzędzi do scrapowania danych zmienia Twoją sytuację prawną,
- czy możesz pobierać informacje dostępne za paywallem,
- czy cel, w którym scrapujesz dane ma znaczenie,
- jak wygląda kwestia wykorzystania danych udostępnianych przez podmioty publiczne.
Proces scrapowania danych ze stron internetowych
Wszystko, co za chwilę przeczytasz jest wynikiem researchu, który przeprowadziłam. Nie jestem osobą techniczną i absolutnie nie stawiam się w tym zakresie w roli eksperta ;) Poznanie technikaliów tego procesu jest jednak ważne przy prawnej ocenie kroków, które przewiduje web scraping.
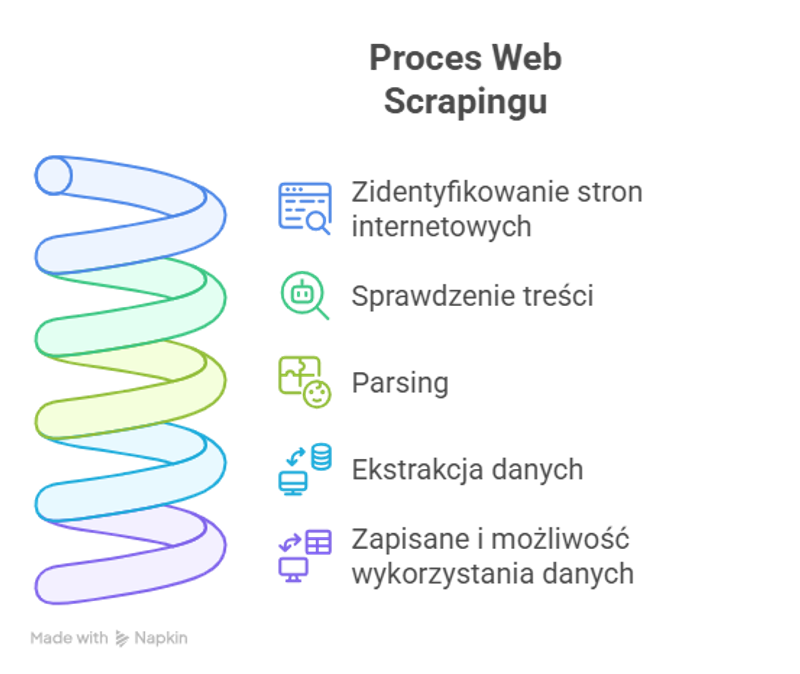
Web scraping pozwala na pozyskanie ustrukturyzowanych danych ze źródeł w nieustrukturyzowanej formie. Do scrapowania stron będzie używany program (np. bot, pojedynczy skrypt) automatycznie wykonujący zadania na stronie internetowej zgodnie z przyjętymi instrukcjami.
- Pierwszym krokiem jest zidentyfikowanie stron internetowych, które program ma za zadanie sprawdzić.
- Program sprawdza strony internetowe pod kątem treści na nich umieszczonych. Podczas sprawdzania dochodzi do ściągnięcia danych ze strony internetowej. Pod kątem prawnym można ten krok porównać do przeglądania stron internetowych. Jako czytelnicy stron zapisujemy ich treść, czyli tymczasowo zwielokrotniamy utwór.
- Parsing. Ściągnięta treść jest poddawana rozbiórce na poszczególne części - tak, aby wydzielić bardziej ustrukturyzowane fragmenty, które nie będą podlegały dalszym procesom oraz te, które program będzie scrapować. Ten krok nadal odbywa się wyłącznie w pamięci operacyjnej.
- Ekstrakcja danych. Dopiero w tej części mówimy o właściwym scrapowaniu danych, czyli pobraniu “na stałe” na serwer danych, które zostały przefiltrowane na wcześniejszym etapie. Dotychczas poprawne byłoby użycie określenia: web crawling. W tym miejscu pobranie danych ze strony to już nie jest tymczasowe zwielokrotnienie.
- Zapisanie danych i możliwość edycji, dalszego wykorzystania. Na tym etapie przetwarzasz pozyskane dane do formatu, który będzie dla Ciebie odpowiedni do dalszej pracy.
Kilka razy użyłam pojęcia zwielokrotnianie utworu. O co chodzi i czemu o tym piszę?
Dopóki kopia treści strony internetowej jest wyświetlana wyłącznie na ekranie urządzenia i przechowywana w pamięci podręcznej urządzenia, nie musisz uzyskiwać zezwolenia twórcy na korzystanie z tej treści. Przykład: dopóki oglądasz na serwisie internetowym zdjęcia, których możesz użyć za dodatkową opłatą i zezwoleniem twórcy, to nie naruszasz praw autorskich, mimo że kopia tego zdjęcia jest na ekranie i w pamięci podręcznej Twojego urządzenia. Technicznie i prawnie zwielokrotniasz ten utwór, ale korzystanie w tym zakresie nie jest naruszeniem praw autorskich.
Podstawa prawna:
sprawa C-360/13 Meltwater
Prawo autorskie i prawa pokrewne:
Art. 23(1). [Tymczasowe zwielokrotnienie utworu]
Nie wymaga zezwolenia twórcy tymczasowe zwielokrotnienie, o charakterze przejściowym lub incydentalnym, niemające samodzielnego znaczenia gospodarczego, a stanowiące integralną i niezbędną część procesu technologicznego, którego celem jest wyłącznie umożliwienie:
1) przekazu utworu w systemie teleinformatycznym pomiędzy osobami trzecimi przez pośrednika lub
2) zgodnego z prawem korzystania z utworu.
Przenosząc to na grunt web scrapingu, do momentu ekstrakcji danych, działanie bota spacerującego po stronach internetowych (zapisującego treść stron w pamięci operacyjnej) nie powinno się różnić od zwykłego korzystania ze strony internetowej przez czytelnika. Oczywiście, w zakresie praw autorskich, na ratunek interpretacyjny co do wszystkich kroków web scrapingu przychodzi art. 26(3) PrAut dotyczący legalności text and data mining (więcej o tym w pierwszym artykule z tej serii).
Powyższe odnosi się do kwestii praw autorskich. Co do pozostałych aspektów prawnych web scrapingu, wydaje się, że stanowisko o legalności tymczasowego zwielokrotniania (na gruncie prawa autorskiego) może być wykorzystane jako argument za legalnością “lekkiego scrapowania stron” (czyli w ramach web crawlingu - nie obejmując ekstrakcji danych).
Przejdźmy zatem do omówienia kilku konkretnych przykładów rozważań prawnych, na które możesz się natknąć przy analizowaniu legalności web scrapingu.
Przykład nr 1: Używanie zewnętrznego narzędzia, które oferuje scrapowanie stron
Na rynku istnieje wiele narzędzi umożliwiających scrapowanie (np. Octoparse, Apify). Czy scrapowanie stron internetowych z użyciem takich narzędzi wyłącza Twoją odpowiedzialność za to, co zostanie zescrapowane? Niestety nie.
W Terms and Conditions tych programów przeczytasz wyraźne zaznaczone wyłączenie odpowiedzialności podmiotów oferujących te programy za jakiekolwiek naruszenie praw stron trzecich przez użytkowników platformy (np. w zakresie: praw własności intelektualnej, praw do nazwy lub firmy, nieuczciwej konkurencji, naruszenia warunków korzystania ze stron internetowych lub aplikacji i programów osób trzecich).
W treści T&C Apify znajdziesz nawet poniższe postanowienie:
“Zakładamy, że korzystasz z Platformy i Usług w sposób legalny i etyczny oraz że uzyskałeś/aś, w razie potrzeby, zgodę na ich używanie na docelowych stronach internetowych i/lub w innych źródłach danych.” (tłumaczenie z j.angielskiego)
Tym samym, to użytkownik jest właścicielem ryzyka w tym zakresie. Podobnie też wygląda kwestia ryzyka użytkownika w przypadku, gdy zescrapowane dane będą nieprawdziwe, niekompletne lub gdy będą zawierały złośliwe oprogramowanie.
Przykład nr 2: Scrapowanie za paywallem
Czasami dostęp do treści na stronach internetowych wymaga dodatkowej opłaty. Treść znajduje się za blokadą dostępu, tzw. paywallem. Wolą właściciela strony lub twórcy jest to, aby artykuł nie był publicznie rozpowszechniony. Argument wykorzystania takich materiałów na podstawie dozwolonego użytku (w tym również przepisu dot. text and data mining) nie będzie miał moim zdaniem zastosowania w takiej sytuacji (treść pozostaje przeznaczona dla określonego grona odbiorców).
Rosnącą popularnością cieszą się metody, poradniki, programy, które umożliwiają dostęp do treści będących za paywallem, bez dokonywania płatności. Takie techniki nie są legalne i mogą się wiązać z odpowiedzialnością karną na podstawie art. 267 kodeksu karnego, który to przepis dotyczy hackingu:
Podstawa prawna:
art. 267 Kodeksu Karnego:
§ 1. Kto bez uprawnienia uzyskuje dostęp do informacji dla niego nieprzeznaczonej, otwierając zamknięte pismo, podłączając się do sieci telekomunikacyjnej lub przełamując albo omijając elektroniczne, magnetyczne, informatyczne lub inne szczególne jej zabezpieczenie, podlega grzywnie, karze ograniczenia wolności albo pozbawienia wolności do lat 2.
§ 2. Tej samej karze podlega, kto bez uprawnienia uzyskuje dostęp do całości lub części systemu informatycznego.
Problem pojawia się w momencie, gdy teoretycznie na ekranie użytkownika jest blokada dostępu i konieczność podjęcia dodatkowej akcji przez czytelnika, aby przeczytać tekst, jednak w html kodu strony dane są widoczne. To się zdarza. W takiej sytuacji, program scrapujący stronę będzie działał podobnie jak w przypadku innych stron bez paywalla, a z technicznego punktu widzenia nie dojdzie do przełamywania jakichkolwiek zabezpieczeń. W takiej sytuacji wydaje się, że można jednak rozpatrywać pociągnięcie do odpowiedzialności z art. 267 § 2 Kodeksu Karnego.
Przed rozpoczęciem scrapowania stron, koniecznie sprawdź, czy na stronach internetowych jest blokada dostępu (paywall). Nie posiłkuj się wątpliwymi prawnie metodami dostępu do ograniczonej treści.
Przykład nr 3: Użytek niekomercyjny (np. badania, edukacja, nauka)
W przypadku scrapowania do celów naukowych, edukacyjnych lub prywatnych obowiązują nieco łagodniejsze zasady. Należy jednak z dużą ostrożnością podchodzić do oceny, czy w danej sytuacji na pewno będzie miał zastosowanie wyjątek z poniższych przepisów:
- Przepisy RODO:
- czynności osobiste lub o czysto domowym charakterze wykonywane przez osobę fizyczną są wyłączone spod przepisów RODO (art. 2 ust. 2 lit. c RODO),
- czynności do celów naukowych i edukacyjnych: do takich czynności RODO znajduje zastosowanie. Należy więc dokładnie przeanalizować podstawy prawne i obowiązki w tym zakresie.
- Przepisy Ustawy o prawie autorskim i prawach pokrewnych:
- własny użytek osobisty stanowi wyjątek w ramach dozwolonego użytku (art. 23 ust. 1 PrAut),
- cele naukowe, badawcze: text and data mining dla instytucji naukowych, badawczych, o których mowa w art. 26(3) PrAut dla celów naukowych, jeżeli czynności te nie są dokonywane w celu osiągnięcia korzyści majątkowej. Zastosowanie przez autora klauzuli opt-out nie ogranicza możliwości skorzystania z TDM przez instytucje naukowe.
- Przepisy Ustawy o ochronie baz danych:
- w zakresie nieistotnej części bazy danych publicznie udostępnionej użytkownik może ją pobierać i wtórnie wykorzystywać (art. 7 ust. 1 Ustawy o ochronie baz danych) - niezależnie od celu,
- użytek osobisty:
- w zakresie istotnej części bazy danych w kontekście scrapowania danych nie znajdzie zastosowania wyjątek dotyczący możliwości korzystania do własnego użytku osobistego, ponieważ wyjątek ten dotyczy tylko nieelektronicznych baz danych (art. 8 ust. 1 pkt 1 Ustawy o ochronie baz danych)
- cele naukowe, badawcze:
- w zakresie istotnej części bazy danych publicznie udostępnionej można z niej korzystać w celach dydaktycznych lub badawczych w charakterze ilustracji, ze wskazaniem źródła, jeżeli takie korzystanie jest uzasadnione niekomercyjnym celem, dla którego wykorzystano bazę (art. 8 ust. 1 pkt 2 Ustawy o ochronie baz danych),
- text and data mining dla instytucji dziedzictwa kulturowego oraz innych podmiotów badawczych, które mogą zwielokrotniać bazy danych w celu eksploracji tekstów i danych do celów naukowych, jeżeli czynności te nie są dokonywane w celu osiągnięcia korzyści majątkowej (art. 8b ust. 1 Ustawy o ochronie baz danych). Zastosowanie przez autora klauzuli opt-out nie ogranicza możliwości skorzystania z TDM przez instytucje dziedzictwa kulturowego.
- Zastrzeżenia na stronie internetowej obowiązują, niezależnie od tego, jaki będzie cel scrapowania danych.
W zakresie przepisów dot. uczciwej konkurencji - nie będą miały zastosowania, ponieważ rozpatrujemy wyłącznie niekomercyjny charakter scrapowania danych. Jeżeli nie widzisz powyżej wyjątku w zakresie osobistego użytku lub naukowego celu, to zastosowanie znajdą ogólne reguły oceny legalności scrapowania danych, które zostały omówione w pierwszej części artykułu.
Przykład nr 4: Dane z instytucji publicznych dla użytku komercyjnego
W przypadku danych pochodzących z instytucji publicznych (np. statystyki GUS) obowiązuje zasada otwartości danych publicznych. Wynika z przepisów Ustawy o otwartych danych i ponownym wykorzystywaniu informacji sektora publicznego.
Zasadą jest, że każdemu, niezależnie, czy dotyczy to celu komercyjnego czy niekomercyjnego, przysługuje prawo do ponownego wykorzystania informacji sektora publicznego:
- udostępnianych np. w Biuletynie Informacji Publicznej podmiotu zobowiązanego (np. jednostki sektora finansów publicznych) lub w portalu danych,
- przekazanych na wniosek o ponowne wykorzystanie.
Prawo to jednak może podlegać pewnym ograniczeniom - np. w zakresie i na zasadach określonych w przepisach o ochronie informacji niejawnych oraz o ochronie innych tajemnic ustawowo chronionych. Dostęp do chronionych danych jest możliwy wyłącznie na wniosek: https://dane.gov.pl/pl/dga/information.
Podmiot zobowiązany, jeżeli to możliwe, udostępnia lub przekazuje informacje sektora publicznego, jako otwarte dane, w celu ponownego wykorzystywania. Podmiot zobowiązany może określić warunki ponownego wykorzystania, np. obowiązek wskazania źródła danych. Brak informacji o warunkach ponownego wykorzystywania informacji udostępnionych w BIP lub w portalu danych oznacza, że podmiot nie wskazał żadnych warunków ponownego wykorzystywania informacji.
Podsumowanie
Web scraping może być niezwykle użytecznym narzędziem do pozyskiwania danych, jednak jego legalność zależy od kontekstu, celu oraz źródła danych. Kluczowe jest zrozumienie, że z prawnego punktu widzenia samo przeglądanie stron czy tymczasowe zwielokrotnianie ich treści (web crawling) zazwyczaj nie narusza prawa, natomiast trwałe pobieranie i wykorzystywanie danych wymaga już szczególnej ostrożności.
Korzystanie z dostępnych programów do scrapowania nie zwalnia z odpowiedzialności, a scrapowanie treści ukrytych za paywallem lub zabezpieczeniami może prowadzić do odpowiedzialności. W stosunku do scrapowania w celach naukowych przez instytucje badawcze lub dla celów osobistych zastosowanie mogą znaleźć nieco łagodniejsze przepisy, chociaż należy bardzo ostrożnościowo i zawężająco przyjmować daną ocenę sytuacji. Jeżeli chodzi natomiast o wykorzystanie danych publikowanych przez instytucje publiczne, to istnieje zasada otwartości tych danych, jednak należy każdorazowo sprawdzić, czy podmiot nie zastrzegł specyficznych warunków wykorzystywania informacji.
Podsumowując – web scraping sam w sobie nie jest nielegalny, ale jego sposób, zakres i cel mogą przesądzić o tym, czy stanie się on działaniem zgodnym z prawem, czy potencjalnie ryzykownym. Świadome planowanie procesu, znajomość przepisów i analiza technicznych aspektów to najlepsze zabezpieczenie.
Podstawy prawne:
- RODO - Rozporządzenie Parlamentu Europejskiego i Rady [UE] nr 2016/679 z 27 kwietnia 2016 r. w sprawie ochrony osób fizycznych w związku z przetwarzaniem danych osobowych i w sprawie swobodnego przepływu takich danych oraz uchylenia dyrektywy 95/46/WE (ogólne rozporządzenie o ochronie danych),
- Ustawa z dnia 4 lutego 1994 r. o prawie autorskim i prawach pokrewnych (Dz.U. z 2025 r. poz. 24),
- Ustawa z dnia 27 lipca 2001 r. o ochronie baz danych (Dz.U. z 2024 r. poz. 1769),
- Ustawa z dnia 11 sierpnia 2021 r. o otwartych danych i ponownym wykorzystywaniu informacji sektora publicznego (Dz. U. z 2021 r. poz. 1641),
- Ustawa z dnia 6 czerwca 1997 r. - Kodeks Karny z dnia 6 czerwca 1997 r. (Dz. U. z 2025 r. poz. 383).
Jestem radcą prawnym z doświadczeniem w obszarze compliance i pasją do prawa nowych technologii. Na blogu znajdziesz treści dotyczące prawa IT – compliance, AI, cyberbezpieczeństwa, RODO, e-commerce oraz prawa autorskiego.
Nr wpisu: KT5201